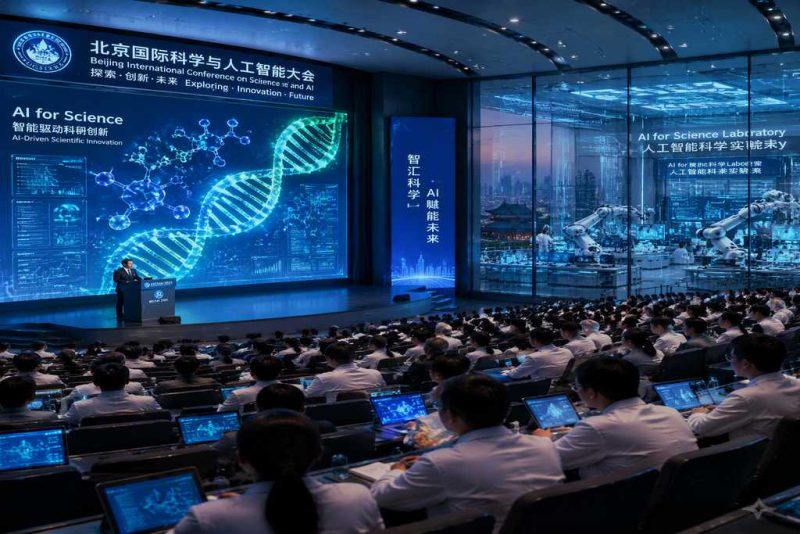


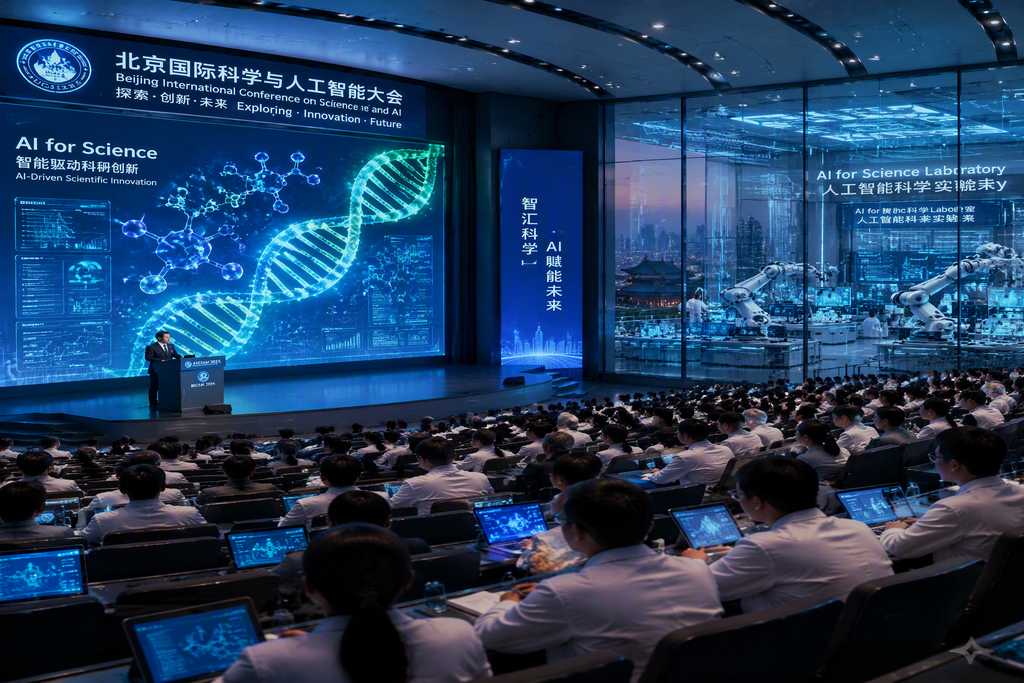
8月21日早晨,北京中关村。一位头发花白的院士站在讲台上,身后的大屏幕只放着一张PPT,上面写着六个字:”科学智能下半场。”
台下坐着近50位院士、80余位青年学者,加上来自政府、高校、科研院所和企业的2500名参会者。这是2026科学智能大会的开幕式。鄂维南院士开口的第一句话不是讲技术突破,而是讲”问题”:当前科研体系以论文发表为核心衡量标准,客观上稀释了”自由探索”与”科学发现”的初心。
台下一片安静。
因为每个人都知道,他说的是真话。AI正在改变科研的方式,但科研体系本身——评职称要论文、申基金要论文、毕业要论文——还没跟上。这种错位,才是科学智能真正需要面对的”下半场”。
8月21日上午:鄂维南的”下半场”宣言
时间回到当天9点。中国科学院院士、北京大学数学科学学院讲席教授鄂维南走上主论坛讲台。他的报告核心观点是:科学智能已从”探索AI方法”的上半年,进入”系统性变革科研体系”的下半年。
这不是一句口号。
鄂维南具体解释了AI正在重塑科研的三个环节:知识获取、理论计算和实验工具。过去做科研,是”读文献→提假设→做实验→发论文”的线性流程;现在AI介入后,变成了”AI辅助文献综述→AI辅助假设生成→自主实验室自动实验→平台化科研协同”的闭环流程。他称之为”干湿闭环”——”干”是计算模拟,”湿”是实验验证,两者通过AI平台无缝衔接。
但问题在于,现有的科研评价体系还是为旧流程设计的。论文数量决定了科研人员的晋升、经费和生存空间,而不是AI辅助发现的效率和深度。鄂维南说,必须推动”科研平权化”,让有能力的个人和团队都能参与科技创新,同时切实保护自由探索这一颠覆性创新的核心要素。
8月21日中午:张林峰的基础设施论
上午的第二个重磅报告来自深势科技创始人兼首席科学家、北京科学智能研究院理事长张林峰。他的核心论点是:科学智能的落地,必须基础设施先行。
什么是基础设施?张林峰列举了三类:科研基础大模型、高质量科学数据与语料、自主实验室。这三样东西,缺任何一样,科学智能都无法从”论文里的概念”变成”实验室里的工具”。
他的判断很直接:”科学智能要真正服务于具体科学问题,从方法探索走向科研实践,形成经得起科研实践检验的成果。”换句话说,不能只发论文,得真做出来。
台下有人点头。因为过去两年,AI for Science的论文发了不少,但真正落地到具体科研场景、被一线科学家采纳的工具,屈指可数。张林峰的话,戳中了一个全行业的隐痛。
8月21日下午:王坚的”词元化”洞察
下午的议程转到了中国工程院院士、之江实验室主任、阿里云创始人王坚。他抛出了一个独特视角:词元(Token)化的科学数据对科学智能至关重要。
什么意思?
科学数据过去是分散的——论文是论文的格式,实验数据是实验数据的格式,基因序列是基因序列的格式。AI要处理这些数据,先得把它们统一成”词元”——一种机器能理解的标准化信息单元。这个过程叫”词元化”。
王坚认为,词元化一旦完成,多学科交叉、跨学科融合的门槛将被更多科研工作者跨越。因为不再需要学懂另一个领域的全部知识体系,只需要让AI帮你翻译和整合。这就像当年互联网把信息数字化一样,词元化是把科学知识”AI化”的前提。
8月21日下午:崔铁军与谢晓亮的成果展示
紧接着,两位院士分别展示了各自领域的AI赋能案例。
中国科学院院士、东南大学毫米波国家重点实验室主任崔铁军介绍了信息超材料新体系。这项技术在AI时代可以支撑三大关键基础设施,展现了科技创新和产业创新深度融合的示范价值。简单理解,信息超材料能让电磁波”可编程”,这意味着从天线到雷达到通信基站,硬件设备可以通过软件重新定义功能。
中国科学院院士、昌平实验室主任谢晓亮则以具体成果案例,分析了大数据和人工智能对生物医学研究范式带来的巨大转变。他指出,精准生物大数据和科学AI是赋能生物医药的关键。在谢晓亮的实验室里,AI已经在蛋白质结构预测、药物靶点筛选和基因测序分析等环节深度嵌入,大幅缩短了从发现到验证的周期。
这不是PPT里的未来。
这是已经发生的事实。
8月21日傍晚:北京发布首批典型案例
当天全体会议的最后环节,北京市科委、中关村管委会发布了”北京市首批人工智能赋能科学研究典型案例”。这些案例从基础研究延伸到产业应用,系统展示了北京在AI赋能科学研究关键要素上的创新成果。
同期,海淀区发布了”中关村(海淀)科学智能创新集聚区”。这个集聚区的定位是构建与新型科研范式相匹配的空间格局和创新生态,打造从源头创新到产业化落地的完整创新链条。海淀区的目标很明确:建成具有国际影响力的科学智能发展新地标。
从政策层面看,这意味着北京市正式把”AI for Science”作为城市科技创新战略的核心方向之一。不是口号,是实打实划地、给钱、配资源。
从方法到体系:科学智能的真正拐点
如果把2026科学智能大会放在更长的时间线上看,会发现一个清晰的转折信号。
2023年,AI for Science还是学术论文里的概念,大多数人讨论的是”AI能不能帮科学家做研究”。2024年,AlphaFold等工具开始被一线实验室使用,讨论变成”AI能帮科学家做什么”。2025年,自主实验室和科研大模型开始出现,讨论变成”AI能帮科学家做多少”。
到2026年,鄂维南说出了那句”下半场”——讨论终于变成了”AI如何改变科研体系本身”。
这个转变的意义在于:科学智能不再是”给科学家加一个AI助手”的问题,而是”重新定义什么是科研”的问题。当知识获取、假设生成、实验验证、论文撰写都可以被AI加速甚至替代时,科研的核心价值在哪里?在问题提出的能力、在跨领域洞察的深度、在对未知方向的直觉。
鄂维南说得很清楚:必须保护”自由探索”。因为那才是颠覆性创新的种子。AI可以帮你走完从假设到验证的路,但”提出什么假设”这件事,目前还需要人类的直觉和勇气。
2026科学智能大会为期两天,14场平行会议推出百余场报告。但真正的价值不在报告数量,而在于一个共识正在形成:科学智能的下半场,拼的不是谁的模型更大,而是谁的科研体系先完成重构。
在这场重构里,中国可能比任何国家都更有机会跑在前面。因为我们有最大的科研人口、最丰富的应用场景、最急迫的产业升级需求。但能不能真的跑赢,取决于论文之外的勇气。
“科学智能已进入下半场。”鄂维南的这句话,也许五年后回看,会成为中国科研范式变革的起点。也可能,只是一场大会的注脚。区别只在于,台下那些安静听讲的年轻人,回去之后做了什么。