

同一间展厅,两套完全不同的技术哲学。
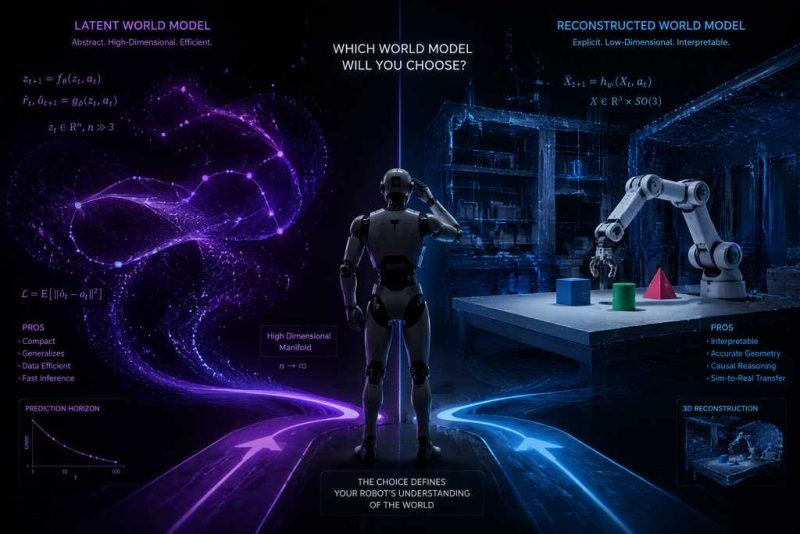
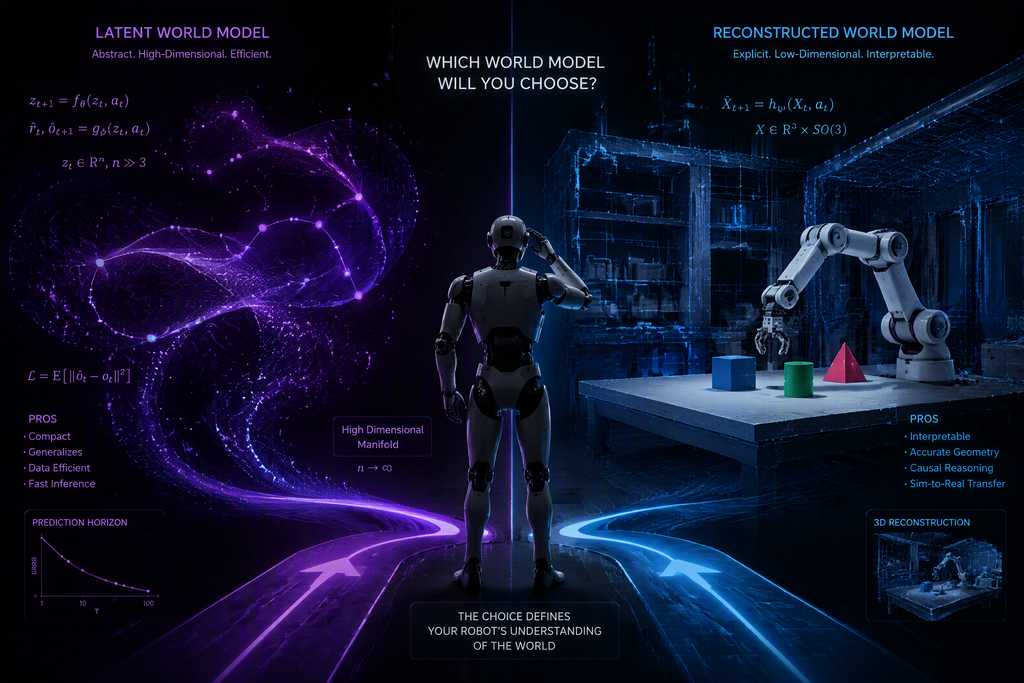
2026世界机器人大会上,”世界模型”从学术黑话变成了产业热词。但当你走进展区逐个展台看完,会发现一个有意思的现象:大家嘴上都说”世界模型”,干的却是两件截然不同的事。一条路是”空间世界模型+强化学习”,在高维隐空间做时空推理,不追求复刻原子级物理细节。另一条路是构建三维几何物理正确的可交互环境,把世界模型视作生成式AI的”皇冠上的明珠”。
这不是技术路线的分支。
这是对”什么是智能”的不同回答。
🔍 世界模型到底是什么
先说清楚定义。世界模型是具备对物理世界因果理解与未来推演能力的智能系统,是机器人”看懂世界”和”改变世界”的关键技术底座。图灵奖得主杨立昆将其定义为”能预测行动后果的内部模拟器”,是机器人认知世界的核心引擎。斯坦福大学教授李飞飞则将其视作实现空间智能的核心路径——”AI要理解、生成、推理并与三维空间交互,构建大型世界模型是最重要的路径”。北京智源人工智能研究院院长王仲远认为,世界模型是下一代人工智能的基座模型。
一句话:让AI在行动之前,先在脑子里预演一遍。
🧩 路线一:隐式推演派
这一派核心理念是——不需要精确复刻物理世界,只需要”大致正确”。在高维隐空间中做时空推理,效仿人类依靠”大致正确”的认知完成任务。就像你接一个掉落的杯子,你不会精确计算重力加速度和抛物线,但你的手就是能接住。支持者认为,追求原子级物理细节是过度工程化,人类认知系统本身就不需要精确到那个程度。
效率高。计算量可控。
但泛化到全新场景时,”大致正确”可能变成”大致错误”。
🅱 路线二:物理重建派
这一派要较真得多。他们要构建的是三维几何物理正确的可交互环境。理想的世界模型不仅能生成机器人末端的有效执行轨迹,还可以预测机器人作用于环境后,环境会发生怎样真实的动态改变。听起来更”正确”,但代价是巨大的算力和数据需求。跨维智能创始人贾奎直言——”相较于大语言模型、VLA模型,世界模型的能力上限高出很多,当然,它对数据的需求也十分庞大。”
精确。可信。
但贵。而且慢。
📊 两条路线横向对比
把两条路线放在一张表里,差异立刻清晰:
– 核心理念:隐式推演追求”大致正确” vs 物理重建追求”精确还原”
– 计算需求:隐式推演较低,在高维空间做推理 vs 物理重建极高,需三维环境仿真
– 泛化能力:隐式推演依赖训练数据分布 vs 物理重建理论上更强
– 落地速度:隐式推演快,已有商业案例 vs 物理重建慢,仍在验证阶段
– 数据依赖:隐式推演中等 vs 物理重建极高
两条路,各有各的赌注。
🗂️ 谁先落地了
蚂蚁灵波科技的智慧药房分拣方案已在上海国大药房正式上岗,承担夜班分拣任务。搭载全栈大脑2.0的机器人无需调整原有货架布局,即可在原始门店环境中自主接单、识别药品、完成精准分拣,是行业首个落地真实药房环境的药品分拣方案。大晓机器人同步发布”晓满””晓新””晓途”三套行业解决方案,分别切入即时零售、酒店服务、户外开放三大场景。”晓满”即时零售方案已落地烧卖购、中石油便利店等连锁渠道,实现天级部署、最快次日上线。
值得注意的是,这些已落地案例走的都是”大致正确”的路线。
先能用。
再谈好不好。
⚠️ 数据缺口:99%的坎
截至2026年初,全球合规可用的真实物理交互数据仅约50万小时。而具身智能商业化落地需要千万小时级数据。缺口超过99%。无问智科提出的解法是构建”采集世界—生成世界—模拟世界”的完整闭环,其长三角数据采集训练场拥有8000平方米固定场景、505亩室外场地与937平方公里全域开放场景,年产能超千万条数据。但50万小时到千万小时,这道坎不是建个训练场就能迈过去的。
99%的缺口怎么补,是整个行业的共同命题。
🤔 ChatGPT时刻:2028还是更远
银河通用机器人王鹤预测,具身智能有望在2028年迎来类似ChatGPT的颠覆性拐点,届时整个行业落地规模和速度将大幅上升。宇树科技王兴兴则更谨慎——在陌生场景中通过语音或文字指令,机器人能够顺利完成约80%的任务,这个临界条件最快可能需要两至三年,慢则可能需要五年甚至十年。王兴兴一针见血地指出,在固定场景下经过充分数据采集训练的AI模型任务成功率可以接近100%,但一旦更换操作的物品或环境,任务成功率就会大幅下降。
80%的泛化成功率。
这道线,决定了一切。
两条路,一个终点。谁先到,谁就定义”世界模型”这个词的最终含义。而在那之前,展厅里的灯光依然亮着,两派工程师各自调试着自己的代码,谁也不看谁。