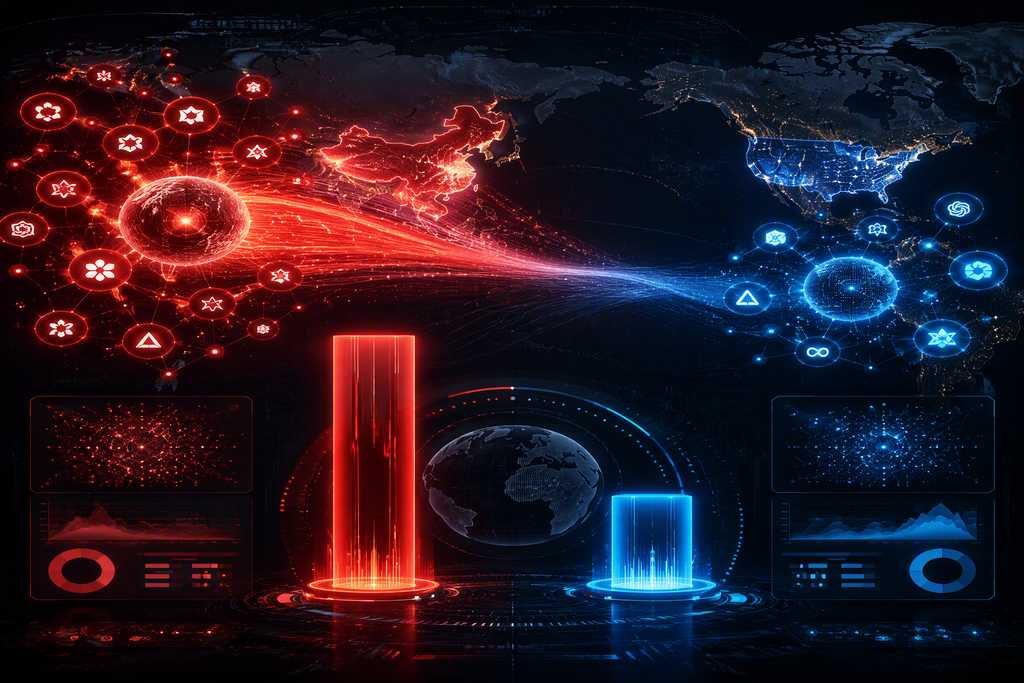
2026年8月17日,Hugging Face发布最新一期全球大模型趋势榜。榜首位置上,赫然是一个中国名字——阿里Qwen3.8-27B。同一天,OpenRouter发布周度数据:全球AI大模型总调用量75.3万亿Token,其中中国模型贡献36.84万亿,美国模型10.26万亿。中国连续第十六周碾压式领先。两组数据放在一起看,画面极其刺眼:一边是硅谷巨头Anthropic即将以650亿美元年化营收冲击史上最大IPO,另一边是全球开发者的真实调用数据早已用脚投了票——中国模型赢了。
这到底意味着什么?
调用量之战:36.84万亿 vs 10.26万亿
OpenRouter的周度数据是观察全球AI模型真实使用情况最可靠的第三方指标。与发布会上的跑分不同,调用量反映的是开发者在真实业务场景中的选择——每一次API调用都意味着真金白银的Token消耗,没有半点虚的。
上周(8月10日至16日)的数据呈现出以下格局:
– 全球总调用量:75.3万亿Token,环比增长9.13%
– 中国模型周调用量:36.84万亿Token,环比增长7.56%
– 美国模型周调用量:10.26万亿Token,环比增长11.89%
– 中国模型占比:约48.9%
– 美国模型占比:约13.6%
差距。
三倍半。中国模型的周调用量是美国的三倍半,而且这个差距已经维持了整整十六周。值得注意的是,美国模型的环比增速(11.89%)略高于中国(7.56%),这意味着差距在缓慢收窄——但按照当前增速,美国追平中国至少需要数年时间。
更重要的是,这十六周的领先并非靠某个单一模型的爆发,而是整个中国AI模型生态的集体崛起。从DeepSeek到通义千问,从智谱GLM到小米MiMo,多家中国厂商的模型同时跻身全球调用量前列。这种”集团军”式的优势,远比单一模型的领先更难被颠覆。
趋势榜之王:Qwen3.8-27B的两天百万下载
8月17日,阿里Qwen3.8-27B登顶Hugging Face全球大模型趋势榜。这个成绩的含金量在于:该模型开源仅两天,下载量便突破100万次。
Hugging Face在最新报告中明确指出,阿里千问大模型已成为全球开源社区的基座模型。这意味着什么?意味着全球开发者不只是”试用”Qwen,而是在它的基础上构建自己的产品——微调、适配、部署、二次开发。基座模型的价值远高于普通开源模型,它相当于AI世界的”操作系统”。
100万。
两天。这个数字背后是一个正在快速膨胀的生态。截至目前,基于阿里Qwen的衍生模型已经超过15万个。从平头哥到英伟达,从AMD到联发科,全球芯片与推理框架生态正在围绕Qwen快速适配。当一个模型成为硬件厂商主动适配的标准时,它的生态护城河就已经挖好了。
参数鸿沟:2.78万亿 vs 1300亿
Hugging Face的报告还揭示了一个更深层的数据:2026年以来,中国发布的最大开源模型参数峰值达到2.78万亿,大多数月份在7540亿至2.78万亿之间;而美国模型在同期多数月份低于1300亿。峰值差距约21倍。
当然。
参数大不等于模型强。训练质量、数据清洗、后训练策略、推理效率,都会影响最终效果。但参数规模的意义不在于单次推理的性能,而在于生态厚度——越大的模型,越能覆盖更多长尾场景,越能成为衍生模型的基础底座。
从战略角度看,中国厂商在开源模型参数规模上的压倒性优势,实际上是在抢占”模型操作系统”的位置。一旦全球开发者的工作流深度绑定某个基座模型,迁移成本将极高,后来者几乎不可能逆转。这就是为什么阿里愿意将2.4万亿参数的Qwen3.8-Max旗舰模型开源——这不是慈善,这是生态占领。
全球前五:清一色中国队
如果将OpenRouter的调用量排名拉出来看,全球前五大模型的名单是这样的:
– 第一名:DeepSeek-V4-Flash,周调用量7.22万亿Token,占比12.7%
– 第二名:小米MiMo-V2.5
– 第三名:腾讯Hy3
– 第四名:DeepSeek-V4-Pro
– 第五名:智谱GLM-5.2
清一色。
中国模型。这不是”中国榜”,是全球榜。DeepSeek-V4-Flash一个模型就贡献了全球12.7%的调用量,超过了任何美国单一模型。这个数据的说服力远超任何发布会上的跑分——开发者是真的在拿这些模型跑业务、跑产品、跑真金白银。
更有意思的是,这份名单中既有互联网巨头(腾讯、小米),也有AI原生公司(DeepSeek、智谱),说明中国AI的繁荣不是某一家公司的独角戏,而是整个产业链的系统性崛起。这种多元竞争的格局,反而比一家独大更健康——它意味着创新来源更分散,技术路线更丰富,生态韧性更强。
开源即话语权:芯片厂商的集体站队
Hugging Face报告中最值得关注的不是模型本身,而是围绕模型形成的生态适配。报告指出,从平头哥、英伟达到AMD、联发科,全球芯片与推理框架生态正在围绕Qwen快速适配。
这意味着:
– 芯片厂商在设计推理加速方案时,会优先考虑Qwen的模型架构
– 推理框架开发者会把Qwen作为默认支持的模型之一
– 企业在选择AI基础设施时,Qwen兼容性成为一个加分项
– Qwen的模型格式可能逐渐成为事实标准
这种生态适配一旦完成,就会形成正反馈循环:越多人用Qwen,越多人围绕Qwen做适配,越多人适配,Qwen的迁移成本就越高,越多人离不开Qwen。这就是开源生态的终极杀招——不是靠技术壁垒锁定用户,而是靠生态惯性锁定用户。
扎克伯格显然看到了这一点。
Meta在8月10日发布Muse Glimmer 30B开放权重模型的同时,扎克伯格同步发布万字长文《The Future is for Everyone》,呼吁降低美国开源AI壁垒。一个美国科技巨头在呼吁降低美国自己的开源壁垒——这个画面本身就说明了竞争压力有多大。当中国厂商以”最广泛尺寸+最宽松协议+持续迭代”的策略席卷开源社区时,美国开源AI的生存空间正在被压缩。
定价权回归:从价格战到价值战
调用量领先带来的最直接后果,是定价权的转移。过去两年,AI行业的价格战由美国公司主导——OpenAI和Anthropic通过不断降价来争夺市场份额。但2026年的局面已经完全不同。
DeepSeek V4-Pro正式版在8月16日逆势涨价,高峰时段输出价格从每百万Token 0.87美元涨至3.96美元,涨幅约4.5倍。这是AI价格战中首个逆势涨价的大型模型厂商。敢于涨价的底气来自两个事实:第一,调用量足够大,即使涨价用户也不会大规模流失;第二,78%的Agent运行Token为缓存命中,有效成本远低于标称价格,用户体感涨价幅度有限。
行业分析认为。
DeepSeek涨价标志着AI模型从”烧钱抢市场”进入”算力稀缺驱动定价”的新阶段。当推理算力供不应求时,低价策略不再可持续。而能够率先涨价的,必然是调用量最大的那个——因为它最不担心用户流失。
同期,Anthropic也在涨价。两家公司一个涨价抢利润,一个涨价保算力,但背后逻辑是相通的:当模型成为基础设施,定价权就从”谁更便宜”转向”谁更不可替代”。而不可替代性,正是由调用量和生态厚度决定的。
两条路线的终局思考
将镜头拉远,2026年8月的全球AI格局呈现出一个清晰的双轨结构。
美国路线:闭源为主,高客单价,IPO变现,追求短期利润最大化。代表选手:Anthropic(年化650亿营收、IPO在即)、OpenAI(年化400亿营收)。
中国路线:开源为主,高调用量,生态占领,追求长期话语权。代表选手:DeepSeek(全球调用量第一)、阿里Qwen(全球开源基座模型)、腾讯Hy3、智谱GLM-5.2、小米MiMo。
两条路线孰优孰劣?这个问题可能没有标准答案。美国路线在财务报表上更漂亮——650亿美元年化营收、利润转正、IPO估值可能超SpaceX。中国路线在生态数据上更扎实——36.84万亿周调用量、15万衍生模型、全球前五清一色中国队。
但有一点是确定的:当开发者用脚投票的数据连续十六周倒向同一方时,行业的重心就已经在悄悄移动了。Anthropic的IPO会很热闹,Qwen的15万衍生模型会很安静。热闹赚的是今天的钱,安静占的是明天的位。
至于五年后谁笑到最后——