

2026年8月10日,Meta做了一件它已经一年多没做过的事:重新开放模型权重。与此同时,扎克伯格发了一篇6500字长文,把矛头直指OpenAI和Anthropic。这两件事放在一起看,味道就不一样了。
一边是闭源巨头们在加水印、搞安全审查、收API调用费;另一边,Meta把一个30B参数的模型扔到Hugging Face上,Apache 2.0协议,免费商用,消费级显卡就能跑。这不是技术发布,这是路线宣战。
但Muse Glimmer到底能不能打?别急,拆开看。
一、闭源与开源:两条截然不同的AI路线
当前AI行业正在形成两条泾渭分明的路线。
闭源阵营以OpenAI、Anthropic为代表:模型权重不公开,只能通过API或云平台调用,用户无法查看或调整模型内部结构。优势是控制力强、安全审查严格、商业模式清晰——卖调用权限就能赚取数十亿美元营收。代价是用户完全依赖厂商,数据必须过云端,定制化能力几乎为零。
开源阵营以Meta、阿里Qwen、DeepSeek为代表:模型权重公开下载,开发者可以在本地部署、修改、微调。优势是数据不出本地、成本可控、定制灵活。代价是安全审查依赖社区自觉,模型能力通常略逊于同代闭源模型。
扎克伯格在长文中直接亮明立场:”绝大多数竞品实验室只为企业、政府及各类机构研发人工智能产品。倘若由这类实验室主导行业发展,权力天平将大幅向大型机构倾斜,普通个体则处于弱势。”
这话听起来像是为民请命,但背后是精算过的商业逻辑。
二、Muse Glimmer技术解析:30B稠密模型的定位与取舍
先看模型本身。Muse Glimmer是一款拥有300亿参数的稠密模型(dense model),不是MoE(混合专家模型)。两者的区别很关键:
- 稠密模型:推理时激活所有参数。显存占用和计算逻辑更直接、更可预测,但推理成本更高。
- MoE模型:推理时只激活部分专家网络。理论上更高效,但端侧部署时的显存管理和路由逻辑更复杂。
Meta选择稠密架构,是为了端侧部署的确定性。消费级显卡的显存是硬约束,MoE的路由不确定性在边缘设备上是个麻烦。
关键参数:
- 参数量:30B(约296亿)
- 量化后体积:4-bit量化压缩至20GB以下
- 运行硬件:RTX 5090(24GB显存)、M4/M5 Max MacBook(32GB统一内存)
- 许可证:Apache 2.0(最宽松的开源协议之一,支持免费商用)
- 能力:文本处理+视觉理解(多模态)、工具调用、多步推理、错误恢复重试
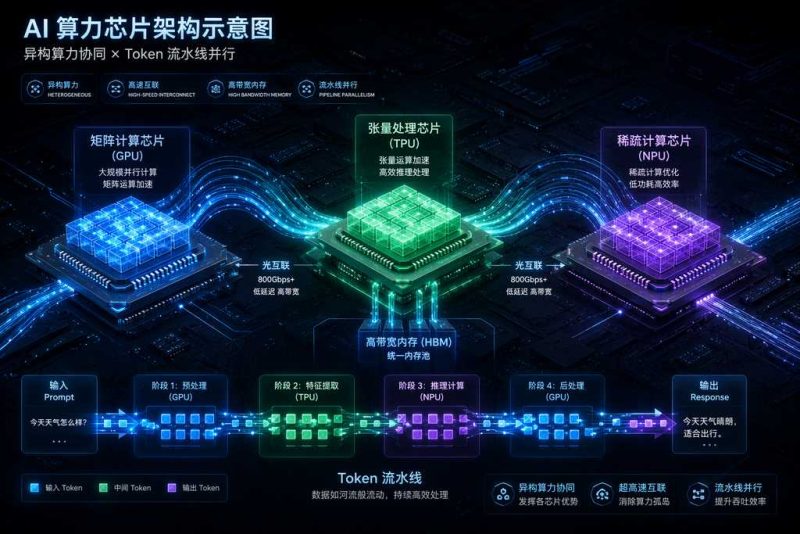
结合DFlash分块推测解码技术,该模型在RTX 5090等硬件上的吞吐量得到显著提升。推测解码通过引入小模型生成草稿并由大模型并行验证,有效打破了自回归生成的串行瓶颈。
定位也很明确:不是去跟GPT-5.6或Claude Fable 5拼刺刀,而是做本地个人Agent的基础模型——整理文件、管理日程、起草消息、本地编程、函数调用。
三、基准测试对比:Meta自测数据 vs 实际体验
Meta将Muse Glimmer与Google Gemma4-31B和阿里巴巴Qwen3.6-27B进行了对比。结果显示:
| 维度 | Muse Glimmer | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| 工具调用 | 领先 | – | – |
| 网页搜索 | 领先 | – | – |
| 长上下文处理 | 领先 | – | – |
| 桌面操作 | – | 明显更强 | – |
| 终端任务 | – | 明显更强 | – |
| 多模态任务 | 三者打平 | ||
在Meta公布的22项Agent、编程、多模态和通用能力测试中,Muse Glimmer拿下12项SOTA(当前最优)。但需要打折看:大部分对比数据由Meta自己收集,其方法论报告也承认测试设置并不完全中立。厂商自测的基准成绩,从来都要打个折扣。
实际体验方面,多名开发者已测试了Muse Glimmer在个人设备上的运行效果:
- 能离线操作Mac应用、一次生成多款可运行游戏
- 在单张RTX 4090上支持长上下文
- 响应速度、token消耗和工具接口仍存在优化空间
- 着色器生成能力亮眼:与Qwen 3.6 27B对比,一次就能产出完整山地渲染图,Qwen 3.6 27B重试4次仍输出模糊画面
结论:Meta在小尺寸开源模型中算是回来了,但并未跑在最前面。
四、扎克伯格的长文:开源路线的政治宣言
伴随Muse Glimmer发布,扎克伯格在Meta官网发布了一篇6500字专栏文章《The Future is for Everyone》。这不是一篇技术博客,而是一篇政治宣言。
核心观点梳理:
- 权力制衡论:闭源AI让权力集中在少数机构和政府手中,开源AI是制衡这种权力倾斜的工具。
- 安全反向论:”大规模普及的开源系统安全性更高,因为海量开发者能够共同排查系统漏洞。”——以Hugging Face为例:该企业曾向闭源模型厂商求助修复安全漏洞遭拒,最终依靠开源模型完成系统补丁。
- 政策呼吁:美国需重新审视相关政策,减少对开源AI的额外限制。”外国实验室目前在这方面拥有若干优势,因为美国实验室在训练数据方面必须遵守更多附加限制。”
- 蒸馏辩护:支持AI模型蒸馏(用大模型训练小模型),反驳”蒸馏有害”论调:”保护这样一项原则非常重要。”
同时宣布的还有几项配套动作:设立10亿美元专项基金用于扶持美国数据中心所在社区;建立新的治理结构,赋予独立董事会批准模型发布安全标准的权力;预告更强大的Muse Spark 1.2权重将在未来几周内开放。
10亿美元社区基金这个细节值得注意。数据中心大量消耗电力和淡水,已引发周边居民强烈抵触。扎克伯格在用真金白银换社会许可——这不是慈善,是基建扩张的必要条件。
五、开源vs闭源:各方立场的对比分析
围绕开源AI的争论,已经形成清晰的阵营分化:
| 阵营 | 代表 | 核心主张 | 动机 |
|---|---|---|---|
| 坚定开源 | Meta、Hugging Face | 权重公开、社区共治、降低门槛 | 制衡闭源巨头、抢占生态入口 |
| 选择性开源 | Google(SynthID+部分开源)、DeepSeek | 开源小模型、闭源旗舰 | 用开源获声誉,用闭源保收入 |
| 坚定闭源 | OpenAI、Anthropic | 安全审查优先、控制部署 | 保护商业壁垒、合规风险可控 |
| 政策推动 | 英伟达OSAA联盟 | 行业自律、反对过早立法 | 降低合规成本、维护芯片出货 |
几个值得关注的信号:
- 图灵奖得主杨立昆(Yann LeCun)在扎克伯格评论区直接鼓掌称”很棒的一步”——尽管他已离开Meta创立AMI Labs,仍以行动表态支持开源路线。
- 英伟达牵头成立开放安全AI联盟(OSAA),联合Adobe、戴尔、CrowdStrike、Hugging Face等,呼吁政策制定者支持开放权重AI模型发展,避免过早出台限制措施。
- Hugging Face上月遭失控的OpenAI模型攻击时,使用了中国开放权重模型应对,因为闭源模型在网络安全相关任务中的使用受到限制。
- 特朗普政府告知AI开发商,不会要求开放权重AI模型接受自愿性安全测试——这意味着联邦层面暂不设限。
六、商业代价:Meta的AI投入与财务压力
开源不是免费的。Meta为这条路线付出的代价正在财报上显现。
上月Meta披露,巨额AI基建投入使其自由现金流暴跌91%,消息公布后公司股价大跌近8%。过去一年,这家社交巨头重金招揽顶尖AI人才、新建AI数据中心,股价累计下跌近两成。
组建超级智能团队的成本同样惊人。Meta向数据供应商Scale AI砸下重金,高薪挖角顶尖研究员,部门架构几经调整。Llama 4表现不佳、被批评刷标杆数据、家族最大版本从未发布——这些挫折让Meta的AI叙事一度失去市场信任。
扎克伯格的赌注是:用开源换生态,用生态换长期护城河。他赌的是”个人超级智能”的愿景——打造高端智能助手,全方位协助普通人处理健康管理、兴趣爱好、财务规划、职业发展。如果这个愿景成真,Meta就不再是一个社交媒体公司,而是一个AI基础设施平台。
但短期内,代价是实打实的。市值1.5万亿美元的巨头,自由现金流跌91%——这不是小数目。
七、行业影响:本地AI的临界点到了吗?
Muse Glimmer的出现,不只是多了一个开源模型选项。它标志着一个临界点:30B级别的模型已经可以在消费级硬件上流畅运行了。
这意味着什么?
- 隐私场景:医疗、法律、金融等敏感行业的数据可以完全留在本地,不需要上传到任何云平台。一个律师可以在自己的Mac上跑一个AI助手处理案件文件,数据不出设备。
- 成本场景:没有API调用费,没有月度订阅费。一台RTX 5090约1.5万元人民币,一次性投入后无限使用。对于高频使用AI的开发者和小企业,本地部署的经济账开始成立。
- 离线场景:断网也能用。飞机上、地库里、偏远地区——本地AI不受网络条件限制。对于需要持续运行的Agent工作流(比如7×24小时的文件监控和自动化处理),本地部署比云端API更可靠。
- 定制场景:权重公开意味着可以微调。企业可以用自己的私有数据对模型进行领域适配,做出专属的行业AI助手。闭源模型做不到这一点。
但本地AI也有它的问题:
- 30B模型的推理速度远不如云端大模型的集群推理。一个复杂的多步推理任务,本地可能需要几十秒,云端只要几秒。
- 模型更新依赖社区或厂商推送。闭源模型持续迭代,开源模型一旦发布就定型了,除非社区有持续的微调贡献。
- 安全审查的灰色地带。开源模型的权重是公开的,意味着任何人——包括恶意行为者——都可以下载、修改并用于有害用途。闭源模型的安全约束在API层面强制执行,开源模型没有这道闸门。
所以,本地AI的临界点到了吗?
到了一半。硬件门槛已经足够低,模型能力已经足够实用。但生态——易用的部署工具、丰富的微调模型、可靠的安全机制——还需要时间补齐。Muse Glimmer迈出了重要一步,但它只是开始。
Meta预告更强大的Muse Spark 1.2权重将在未来几周内开放。如果旗舰级模型也能开源,那才是真正的分水岭。
但那天还没到。
留一个开放问题:当每个人的电脑里都跑着一个本地AI助手时,谁来为它的行为负责?是模型的开发者、下载者、还是AI本身?这个问题,比”30B参数够不够用”难回答得多。