

当一个硅谷创业公司在技术栈里删掉Qwen,它还能不能正常跑起来?这个问题,红杉资本两位合伙人花了数月调查后给出的答案,让整个硅谷都坐不住了。
2026年8月,红杉资本合伙人Dean Meyer与Konstantine Buhler发表了一篇名为《America’s Open-Model Paradox》的文章。文章的核心判断堪称反直觉:美国在闭源前沿模型上确实保持领先地位,但整个AI产业正在对中国开源模型形成深度依赖——而且这种依赖程度,远超所有人的想象。
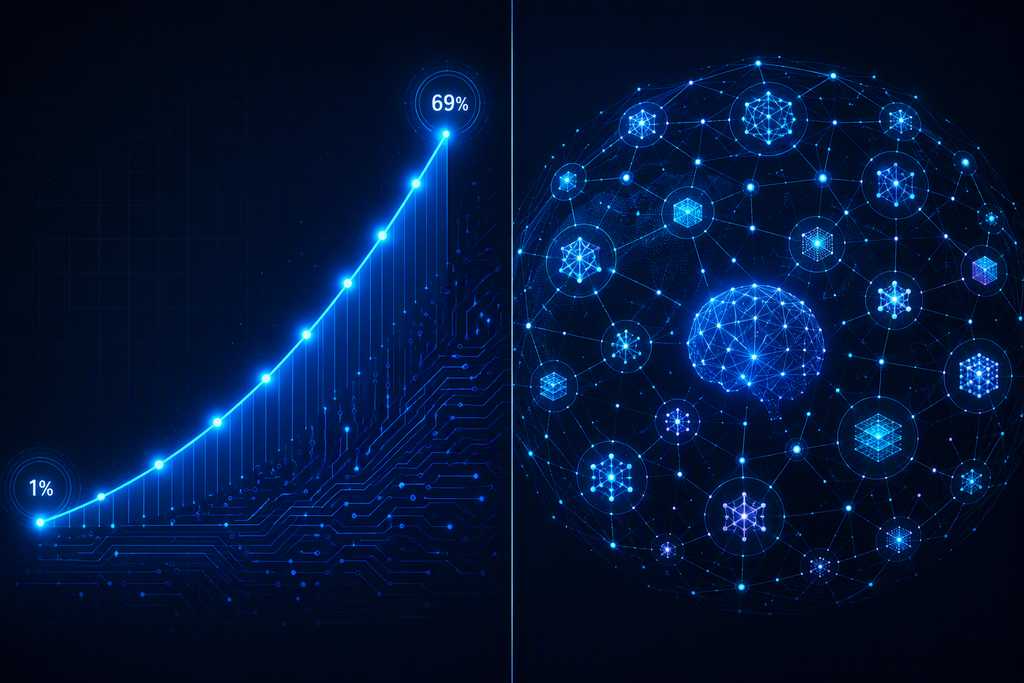
据ATOM报告数据,2024年1月,Qwen在新开源模型微调与适配中的占比仅为1%。到2026年2月,这个数字飙升至69%。两年时间,从百分之一到将近七成。中国开源模型已成为美国创业公司技术栈中难以绕开的基础组件。
这不是危言耸听。
一、1%到69%:一条被忽视的曲线
先看数字。2024年1月,Qwen在全球新开源模型微调与适配中的占比是1%。彼时美国AI创业公司的技术栈里,开源模型的选择还比较多元:Llama系列占据主导地位,Mistral在欧洲异军突起,Qwen只是众多选项之一。但随后发生的事情,像一条被所有人忽视的指数曲线。
到2024年下半年,Qwen的占比开始快速攀升。进入2025年,增速进一步加快。2026年2月,ATOM报告的最新数据显示,Qwen的占比已经达到69%——意味着全球每100个基于新开源模型进行微调适配的项目中,有69个选择了Qwen作为基座。这个数字不仅超过了Llama系列,更是把所有其他开源模型远远甩在身后。
速度惊人。
红杉资本的文章没有停留在数据层面,而是进一步追问:为什么?为什么美国拥有世界上最强大的闭源模型——GPT-5.6、Claude 4.6、Gemini 3.0——但其创业生态却对中国开源模型产生了如此深度的依赖?答案藏在开源模型的核心价值中:可商用、可微调、可私有部署、成本低。对于一家需要将AI能力嵌入产品并规模化交付的创业公司来说,闭源API的调用费用和延迟限制,往往比技术能力本身更致命。
二、开源模型的真正护城河不在模型本身
红杉资本这篇文章最犀利的地方,不在于揭示了一个数据事实,而在于它点破了开源生态竞争的本质:开源模型的护城河不是参数量,不是跑分,而是生态。
当一个模型被足够多的开发者使用、微调、部署、反馈,它就形成了一个自我强化的飞轮。更多的使用者意味着更多的微调变体,更多的变体意味着更多的场景覆盖,更多的场景覆盖又反过来吸引更多使用者。Qwen的69%占比,本质上是这个飞轮高速运转的结果。
飞轮一旦转起来,就很难停。
阿里在Qwen上的策略可以总结为:激进开源、全尺寸覆盖、多模态扩展。从0.5B到110B,从文本到视觉、音频、代码,Qwen几乎在每一个参数区间和每一个模态方向上都提供了开源版本。这种”全矩阵”策略让不同规模、不同需求的开发者都能找到合适的基座模型,而不需要在多个模型家族之间来回切换。
相比之下,Llama系列虽然在2024年仍是开源领域的标杆,但Meta的更新节奏和开源策略相对保守,版本迭代间隔较长,多模态能力覆盖也不够全面。Mistral受限于团队规模和资源,难以在全尺寸矩阵上与阿里正面竞争。差距就这么拉开了。
三、美国AI产业的”开放模型悖论”
红杉资本把这种现象称为”开放模型悖论”(Open-Model Paradox)。美国的AI战略在闭源前沿模型上投入巨大——OpenAI、Anthropic、Google三家公司的训练成本动辄数十亿美元,在能力上确实领跑全球。但在开源模型这条赛道上,美国的优势正在被快速侵蚀。
这不是说Llama不行。Llama 4系列仍然是优秀的开源模型,Meta在AI开源领域的贡献也值得尊敬。但问题在于,单靠一家公司的开源策略,无法构建一个可持续的生态系统。中国的开源模型阵营不仅有Qwen,还有DeepSeek、GLM、Baichuan、Yi等多个系列,形成了一个多层次、多尺寸、多模态的开源模型矩阵。这种集群效应,是单个公司很难对抗的。
更深一层。
美国AI创业公司对中国开源模型的依赖,不仅是技术选择问题,更是地缘政治问题。当前环境下,美国政策层面对AI芯片出口、技术转移设置了严格限制,但开源模型作为软件层面的”公共品”,目前尚未被纳入出口管制范围。这意味着,美国的AI创业公司可以合法地使用中国开源模型,但政策的灰色地带随时可能被收紧。
四、下一个拐点:开源模型会成为AI主权的一部分吗
红杉的文章最后提出了一个更深层的追问:在AI主权(AI Sovereignty)成为各国战略核心议题的背景下,开源模型是否会成为国家AI竞争力的关键组成?
从趋势来看,答案是肯定的。中国工程院士郑纬民在WAIC 2026上指出,Token实际商业价值由延迟、生成速度、稳定性等工程指标决定,而这些指标的基础正是底层模型能力。如果底层模型大量依赖外国开源模型,那么一个国家的AI产业在本质上就受制于外部——即便这个外部是”开源”的。
但”开源”并不等于”永久免费”。
许可证可以修改,更新节奏可以调整,甚至某些版本可以随时撤回。红杉资本的文章暗示了一个可能性:如果中美在AI领域的竞争进一步加剧,开源模型可能成为新的博弈筹码。69%的依赖度意味着,一旦这条供应链出现任何波动,受影响的不仅是某几家创业公司,而是整个美国AI创业生态。
这才是真正的风险。
红杉的文章没有给出明确的政策建议,但它的结论已经足够清晰:在闭源模型竞赛中领先的美国,正在开源模型生态中面临一个结构性挑战。这个挑战不会因为某个新模型的发布而消失,它需要的是系统性的生态建设——更多公司参与开源、更活跃的开发者社区、更可持续的商业模式。
2026年的AI产业格局,正在从”谁的模型更强”演变为”谁的生态更厚”。在闭源赛道上,美国暂时领先。但在开源赛道上,中国正在用69%这个数字发出一个信号:模型能力可以追赶,但生态壁垒一旦形成,追赶的难度将呈指数级增长。
下一个问题或许是:当这个数字从69%继续攀升,硅谷还会淡定吗?