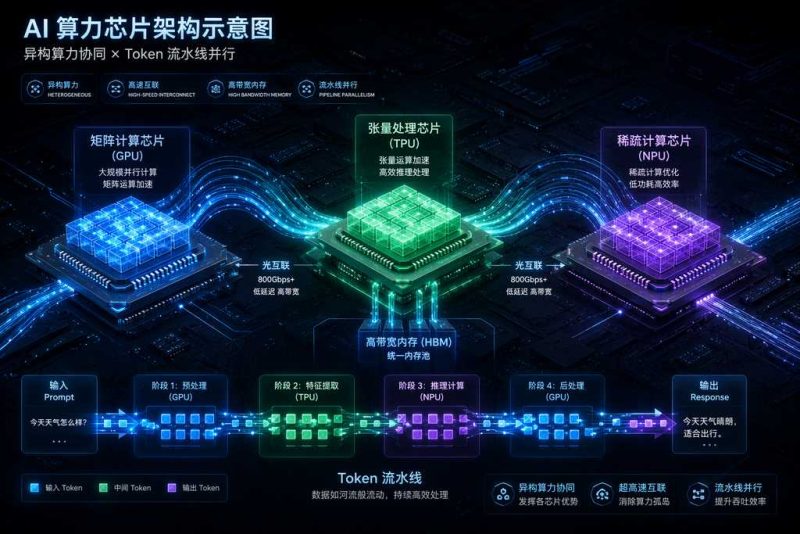


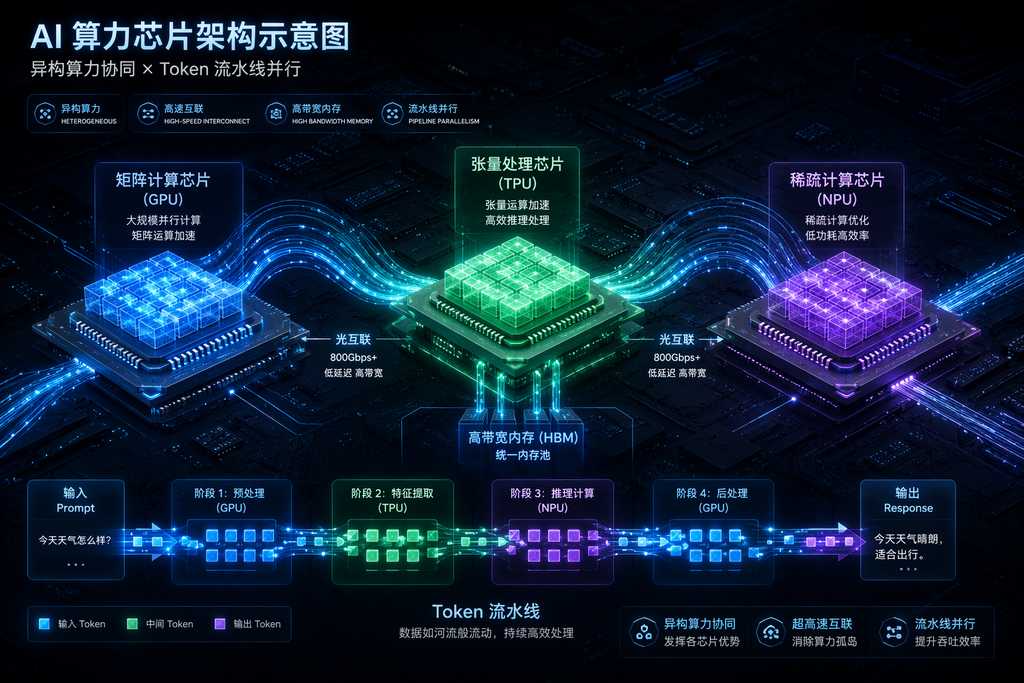
云天励飞在WAIC 2026上发了一张芯片路线图,上面没有标TFLOPS。
这张图把AI推理拆成了三道工序:Prefill(预填充)、Decode Attention(解码注意力)、Decode FFN(解码前馈网络),每道工序用不同的芯片去跑。董事长陈宁在台上说了一句话,台下安静了几秒——”规模化之后,算力的价值指标不是TFLOPS,而是系统稳定产出多少Token、每Token多少钱。”
这句话正在改变整个算力产业的竞争逻辑。
🆚 旧逻辑 vs 新逻辑
| 维度 | 旧逻辑(2023-2025) | 新逻辑(2026-) |
|---|---|---|
| 核心指标 | 单卡TFLOPS | 每Token成本 |
| 竞争焦点 | 谁的芯片算力峰值高 | 谁的系统产出Token多且便宜 |
| 架构思路 | 一颗芯片通吃所有 | 按推理流水线做工序级切分 |
| 互联方式 | 单机Scale-up | 千卡光互联Scale-out |
| 成本衡量 | 买卡花了多少钱 | 跑完一百万Token花了多少钱 |
转变的根本原因:大模型从训练阶段进入推理阶段。
训练的时候,你买几千张卡,跑几个月,出一个大模型。算力消耗是可预测的一次性投入。但推理不是——用户每问一次问题,都要消耗算力。中国AI大模型日均Token调用量已突破140万亿,较2024年初增长超千倍。
140万亿。每天。
这个数字还在涨。当算力消耗从”训练一次”变成”每天烧”,单卡峰值就不再是重点了——系统吞吐和单位成本才是。
🔧 三条技术路线正在赛跑
目前国内算力突围有三条主要路线,各有优劣:
路线一:异构三芯(云天励飞DeepVerse)
把推理流水线拆成三段,每段一颗专用芯片。DeepVerse100P管Prefill,100D管Decode Attention并支持1024卡光互联,100L用3D Memory架构啃Decode FFN。
好处是每个环节效率最优,坏处是三颗芯片的协同调度复杂度极高。这路线还在验证阶段,但思路够大胆。
路线二:RISC-V融合CPU(蓝芯LX500)
48核异构、75 TOPS INT8,统一内存管理消除CPU和加速卡之间的数据搬运。联想问天WR5219 G5服务器已搭载量产下线,实测同等功耗推理+30%、同等吞吐采购成本-20%。
这条路的意义不在单颗芯片参数,在于RISC-V从嵌入式走向了服务器机房。如果RISC-V能在数据中心站稳脚跟,ARM和x86的格局会被重新定义。
路线三:国产GPU旗舰对标(天数智芯天垓300)
基于SIMT架构,对标Hopper架构主流方案。Agent场景首字延迟降约20%,Decode通信延迟降13%,Cosmos3世界模型推理效能超Hopper 10%。
这是正面硬刚的路线——用国产GPU直接对标英伟达Hopper。参数不输,但生态差距还在。CUDA的护城河不是一两年能填平的。
💰 价格战的底层是算力战
为什么大模型API价格能跌到白菜价?不是模型公司在做慈善,是算力成本在下降。
DeepSeek V4首次采用峰谷计费:Pro版每百万输出Token低谷约0.87美元、高峰约1.74美元。Kimi K3的API定价约为Claude Fable 5的三分之一。
这些数字的底层支撑是什么?
- 昇腾950超节点支持1024卡高速互联,让万卡集群”像一台计算机一样协同工作”
- DeepSeek V4-Pro的价格会随超节点量产进一步下调
- 蓝芯LX500让同等吞吐的采购成本下降20%
- 天数智芯天垓300在推理效能上超越Hopper 10%
每一个百分点效率提升,传导到终端就是API价格再降一档。大模型价格战的本质,是算力效率战。
🏠 另一个赛场:桌面AI超算
7月24日,技嘉桌面AI超算竞赛在北京开赛。11支队伍在48小时内基于AI TOP ATOM平台做本地AI开发。
这件事看起来是个小比赛,但背后的趋势值得注意:AI算力正在从云端向桌面端下沉。
本地大模型部署、私有化知识库、模型微调——这些需求催生了一个新市场:桌面级AI超算。数据不出域,是很多企业的硬需求。当桌面设备的算力足够跑量化版万亿参数模型,云计算的垄断地位会被动摇。
当然,桌面AI超算目前还远不能替代云端集群。但它代表了一个方向:算力去中心化。
🌐 大模型厂集体”去英伟达化”
不只中国在找替代方案。
Anthropic已启动自研AI芯片早期规划,与三星谈SF2 2nm代工。Google有TPU,Amazon有Trainium,OpenAI六月刚跟Broadcom端出Jalapeño芯片。
大模型公司集体造芯片,原因只有一个:英伟达太贵了。
当你的模型每天被调用140万亿次,每一分算力成本差异都会被放大成天文数字。与其把钱交给黄仁勋,不如自己造芯片——哪怕良率低、周期长,长期看也比被卡脖子强。
Anthropic选三星而非台积电,核心考量是台积电2nm产能被锁到2028年后,三星Taylor厂2027-2028的窗口更匹配。这个选择本身就说明:芯片产能已经成了战略资源,排队都要抢。
⚡ 还有一个变量
以上所有分析都建立在一个前提上:推理算力需求会持续增长。
如果这个前提变了呢?
比如——模型架构发生根本性突破,万亿参数模型可以被压缩到百亿参数同等效果。或者——端侧芯片性能飞跃,大部分推理在手机上完成,云端算力需求增速放缓。
这些不是空想。Kimi K3已经证明了开源模型追平闭源的可能性。如果模型效率持续提升,算力需求曲线可能不会像现在预测的那样指数增长。
但至少在2026年,这个转折点还没到来。算力战争,才刚刚从”堆GPU”阶段进入”系统效率”阶段。
下一站是哪里,所有人都在找。