

你有没有算过,每月在AI模型上的花销,是不是正在悄悄吃掉你的利润?
硅谷创业者Ben Cera算过。今年4月,他收到了一张接近120万美元的AI账单。注意,是单月。他创办的一人公司Polsia,提供AI驱动的策划、编程和营销服务,付费用户从500人涨到5000人,收入在增长,但AI成本涨得更快。用Anthropic的Opus和Sonnet模型,每多一个用户,亏损就多一层。他在社交媒体上写道:”没人抱怨人工智能的成本,直到账单贵得离谱。”
这不是个例。
整个2026年上半年,美国开发者和中小企业都在经历一场”Token通胀”。模型更强了,调用更频繁了,但单价却迟迟不降。OpenAI年化营收突破400亿美元,Anthropic单季度营收超115亿美元——这些天文数字背后,是千千万万像Ben Cera一样被账单压得喘不过气来的用户。
然后,转机来了。来自中国。
120万到10万:一个开发者的”叛逃”路线图
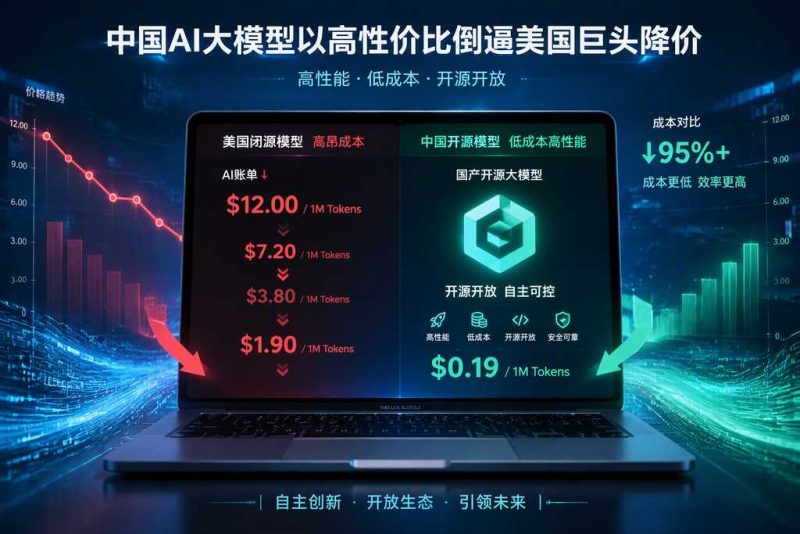
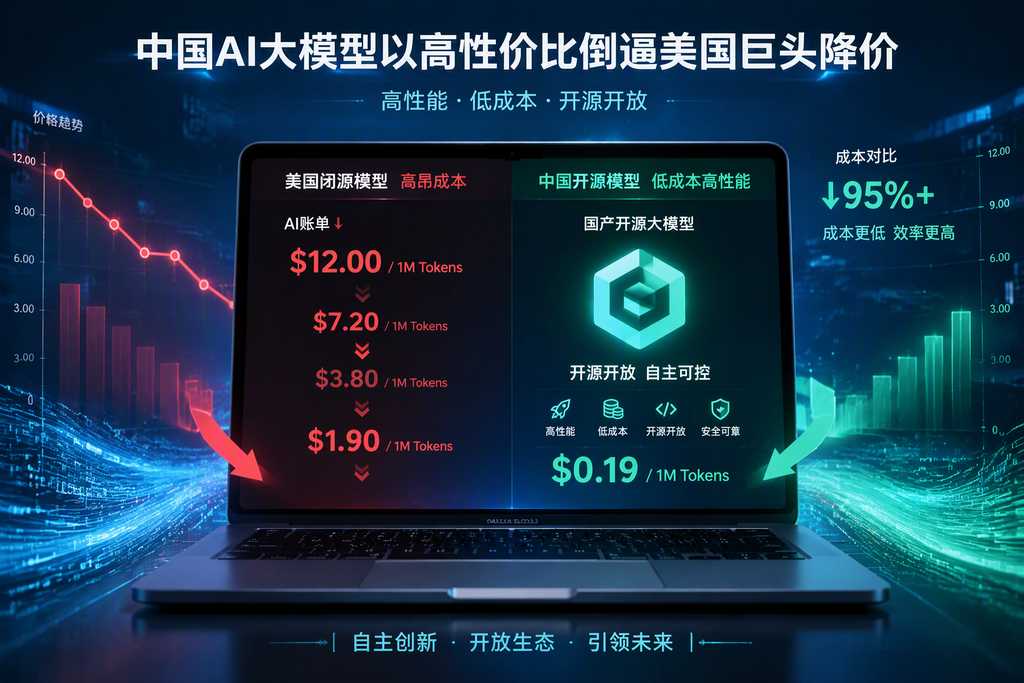
Ben Cera的解决方案很简单——租GPU,部署开源模型。他用了两个月时间,把公司AI月支出从120万美元砍到10万美元左右。用的是MiniMax和GLM。效果呢?公司开始盈利了,甚至能提供免费版服务。
他在帖子下面收到了一个新词:Chinamaxxing。有人戏仿Tokenmaxxing(拼命烧Token),造了这个词,意思是”最大限度地使用中国大模型”。这个词在硅谷开发者圈子里迅速传播开来。
真有效果吗?
数据说话。第三方模型聚合平台OpenRouter显示,8月第一周(8月3日至7日),DeepSeek-V4-Flash新旧版本调用量共计11.31万亿Tokens,而GPT-5.6 Luna的调用量为3.54万亿Tokens——差距接近三倍。再往前一周,API调用榜单排名前五的产品,全部是中国模型。
这不是营销叙事。这是真金白银的投票。
为什么是中国模型?价格只是表象
便宜,是最直观的原因,但远不是全部。Hugging Face最近发布的观察报告揭示了一个更深层的结构性变化:2026年以来大部分月份,中国AI企业发布的最大开源模型,参数规模在7540亿至2.78万亿之间,而美国同行同期多数月份低于1300亿。
规模领先只是一面。在参数超过200亿的中国模型中,超过八成采用宽松授权协议,允许企业和开发者进行二次开发和商业部署。Qwen的衍生模型数量已超过15万个,远超谷歌和Meta的任何一款开源模型。
这意味着什么?
意味着中国模型不只是便宜,而是构建了一整套可定制、可二次开发的生态底座。企业拿到的不只是一个API endpoint,而是一套可以自己掌控的模型能力。对于担心数据安全、供应商锁定和大厂定价权的用户来说,这种”模型自主权”的吸引力远超价格本身。
有意思的是,Hugging Face报告还指出,今年以来美国推出新开源模型最多的公司,不再是谷歌和Meta,而是AMD和英伟达——两家芯片公司。它们用开源模型展示自家GPU的硬件协同能力。真正的模型创新重心,已经东移。
巨头被迫接招:降价潮背后的定价权争夺
中国模型的性价比攻势,正在倒逼美国巨头调整策略。OpenAI年内多次下调API价格,Anthropic推出更便宜的Haiku系列,谷歌Gemini 3.7 Flash三周一迭代、价格砍半——每一步背后都有中国竞争者的影子。
但降价只是第一层反应。更值得关注的是IBM的”不站队”策略。IBM Consulting宣布与OpenAI达成战略合作,在咨询平台上部署GPT-5.6、Codex和ChatGPT Work,同时手握Anthropic和Google Cloud的合作协议。Claude、Gemini、GPT全部接入Watsonx平台。
说白了就是:”我不押谁赢,我帮你们卖货。”
对大企业客户来说,有个中立集成商帮忙按需选模型,确实比all in一家踏实。金融、政府、电信这些合规要求极高的行业,最怕的就是被单一供应商绑架。IBM的策略,本质上是在AI的”模型战国”里,做一个收过路费的中间人。
这也侧面说明一个问题:没有哪个模型能通吃所有场景。不同的任务,需要不同的模型;不同的预算,对应不同的选型逻辑。中国模型在性价比和开源生态上的优势,正在让这种”多模型共存”的格局加速固化。
Chinamaxxing能走多远?三个不确定性
风潮很热,但冷思考不能少。Chinamaxxing要真正从”开发者自发行为”变成”企业级标准选择”,至少面临三个不确定性。
第一,地缘政治。中国模型在海外的大规模采用,已经引起了监管层面的关注。白宫此前对中国开源AI模型的安全测试豁免,表面是松绑,背后是开放权重模型根本管不住的现实。但谁能保证下一届政府不会收紧?数据跨境、模型审计、合规审查——每一项都可能成为绊脚石。
第二,技术迭代速度。中国模型的性价比优势,很大程度上建立在”同等性能下更便宜”的假设上。但如果OpenAI或Anthropic在下一代模型上实现质的飞跃,拉开代际差距,价格优势就会被性能差距稀释。毕竟,Ben Cera最初选择Anthropic,不是因为便宜,而是因为好用。成本只是逼到墙角之后的退路。
第三,生态成熟度。15万个Qwen衍生模型听起来很壮观,但真正经过大规模生产环境验证的有多少?企业选型看的不只是GitHub上的star数,还有SLA、技术支持、安全更新频率。中国模型在海外市场的服务体系,还远没有达到美国巨头的成熟度。
但有一点是确定的:AI模型的定价权,已经不再掌握在任何单一玩家手中。当硅谷开发者开始用”Chinamaxxing”这个词的时候,信号已经非常明确——市场用脚投票的时代,正式开始了。
对中国模型厂商来说,这是最好的窗口期。但窗口期从来不等人。