

上海张江的写字楼里,一个产品经理打开电脑,习惯性地点开DeepSeek的API文档。和昨天不一样的是,定价栏的数字变了——输入1元/百万token,输出2元/百万token,缓存命中低至0.02元。她愣了一下,切到Slack工作群,消息已经刷屏了。
这是2026年7月31日早上9点17分。
DeepSeek V4-Flash正式版API上线公测, Token价格战的导火索被点燃了。同一天, OpenAI宣布GPT-5.6 Luna价格下调最高80%。再往前一天,月之暗面发布旗舰大模型Kimi K3, 美股AI板块一夜蒸发约4700亿美元。三天之内, 全球大模型市场经历了从技术发布到资本地震的完整传导链。
第一站:Kimi K3发布, 硅谷的”意外”
7月30日,月之暗面发布旗舰大模型Kimi K3。这款模型在多项基准测试中表现接近甚至超越部分国际顶级闭源模型,但训练成本和推理成本远低于同类产品。消息传出后,美股AI板块出现集中抛售。
4700亿美元。
17家华尔街投行连夜下调AI芯片企业目标价。摩根大通在报告中直接写道,Kimi K3的发布对AI芯片股而言”无疑是雪上加霜”。高盛合伙人更是直言,算力扩张时代或已走到尽头——如果中国低成本开源模型的性能足够优秀,美国AI巨头天价资本支出的合理性就不复存在。
加州大学伯克利分校教授伊恩·斯托卡的评价更具标志性:中国开源模型与美国最前沿的差距,已从半年缩至2到3个月。
这个判断在硅谷引发了真正的焦虑。
第二站:DeepSeek V4-Flash上线, “全球性价比之王”
7月31日,DeepSeek-V4-Flash正式版API上线公测。总参数2840亿,激活参数仅130亿,采用轻量级MoE架构,支持100万token上下文窗口和最大38.4万token输出。
但真正让市场震动的是定价。
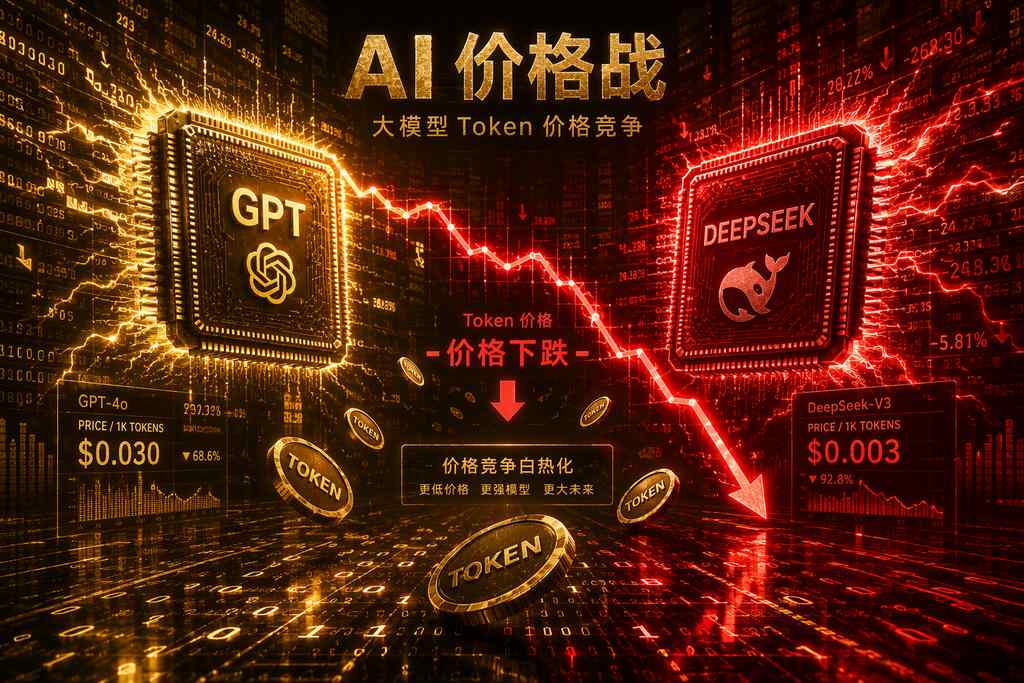
Flash版定价为输入1元/百万token、输出2元/百万token,缓存命中低至0.02元。仅为Pro版的三分之一。同日OpenAI大幅下调GPT-5.6 Luna价格应战,但Flash版单任务成本仍比降价后的Luna低约60%。开发者社区给出了一个直白的称呼——”全球性价比之王”。
更关键的是技术路径的变化。Flash版本未改变模型架构和尺寸,纯粹依靠后训练优化实现能力跃升。Terminal Bench 2.1得分82.7,DeepSWE从7.3飙升至54.4,DSBench-FullStack达68.7。这意味着:轻量化模型同样可以释放强大的智能体能力。
第三站:OpenAI跟进降价, 但方向变了
面对DeepSeek的价格冲击,OpenAI选择跟进。GPT-5.6 Luna模型价格下降约80%,输入价格降至每百万token 0.2美元,输出价格降至1.2美元。Terra模型同步降价。
降价的底气来自推理效率提升。
OpenAI方面表示,模型推理效率持续提升是降价的核心原因,包括生产优化和投机解码技术带来的成本下降。换句话说,不是模型不赚钱了,而是推理成本降到了可以支撑更低定价的水平。
但这里有一个容易被忽略的信号:高智能AI能力正在快速商品化。过去高昂的模型调用成本限制了AI Agent的大规模应用,如今价格门槛降低后,自动化办公、编程助手、客服系统等高频应用的商业模型变得更加可行。
时间线:三天之内发生了什么
把三天的事件串起来看,一条清晰的传导链浮出水面。
7月30日,月之暗面发布Kimi K3,性能接近国际顶级水平,成本远低于同类产品。资本市场率先反应——美股AI板块蒸发约4700亿美元,投行集体下调目标价。
7月31日,DeepSeek V4-Flash上线公测,以极致性价比直接将Token价格拉到新低。OpenAI当日宣布降价应战。中国发改委等多部门同日密集表态,透露截至6月底全国智能算力规模达到去年同期的2.8倍,国产大模型全球总下载量突破100亿次。
8月1日,DeepSeek V4-Pro正式版预告将在8月初发布。开发者社区开始大规模迁移,Flash版原生支持OpenAI Responses API格式,无需修改Base URL即可无缝切换。
三天,三个节点,一条完整的”技术发布→价格传导→生态迁移”链路。
价格战的本质:从参数竞赛到后训练优化
这轮价格战表面上是价格下调,本质上是AI定价逻辑的切换。过去几年,大模型的定价逻辑建立在”参数竞赛”上——参数越多、能力越强、价格越高。但DeepSeek V4-Flash证明了一条新路径:不改架构、不堆参数,纯粹通过后训练优化就能实现能力跃升并大幅降低成本。
这对行业的冲击是结构性的。
如果后训练优化能持续带来性价比提升,那意味着”参数规模”作为定价锚点的时代正在结束。模型能力的获取成本会越来越低,竞争焦点将从”谁造更好的模型”转向”谁能让模型在企业里跑起来”。后者考验的是部署工程能力、场景适配能力和安全治理能力——恰好是WAIC 2026反复强调的”从能聊到能干”的转向。
谁在受益,谁在承压
降价的直接受益者是开发者和AI应用创业者。Token成本降低意味着可以用更低的试错成本构建应用,验证商业模式的周期也在缩短。自动化办公、编程助手、客服系统等高频场景的商业可行性大幅提升。
承压方则分两层。第一层是高定价模型服务商,面临”要么降价、要么流失客户”的两难。第二层是算力硬件企业——如果模型推理效率持续提升导致算力需求增速放缓,高盛”算力扩张时代走到尽头”的判断就不是空穴来风。
但有一个反直觉的判断值得留意:价格下降不会减少算力总需求,反而可能通过应用爆发拉动更大规模的基础设施建设。经济学里管这叫”杰文斯悖论”——效率提升降低了使用成本,反而刺激了总消费量。Token价格下降,用量可能成倍增长。
中国AI开源模型的全球下载量已经突破100亿次。这不是一个孤立的数字。
它和Kimi K3的性能突破、DeepSeek的极致定价、OpenAI的被迫跟进,拼成了一幅完整的图景:全球AI竞争的叙事正在改写。过去由美国主导的”参数竞赛”逻辑,正在被中国开源力量推动的”后训练优化+极致性价比”逻辑补充甚至替代。伯克利教授说的”2到3个月差距”,不是在夸中国,而是在描述一个让硅谷不得不重新思考竞争策略的现实。